
模型配置说明
FastGPT 模型配置说明
介绍
FastGPT 借助 AI Proxy 服务,可以连接到不同的模型提供商。同时 AI Proxy 还提供了负载均衡、模型日志、数据看板等能力,方便检测模型调用情况。
注意事项:
- 目前语音识别模型仅会生效一个,所以配置时候,只需要配置一个即可。
- 系统至少需要一个语言模型和一个索引模型才能正常使用。
运行流程图

模型类型
- 语言模型 - 进行文本对话,多模态模型支持图片识别。
- 索引模型 - 对文本块进行索引,用于相关文本检索。
- 重排模型 - 对检索结果进行重排,用于优化检索排名。
- 语音合成 - 将文本转换为语音。
- 语音识别 - 将语音转换为文本。
特殊术语介绍
- 模型 ID:接口请求时候,Body 中
model字段的值,全局唯一。 - 模型名: 用于展示的模型名称,可以自定义。
- 模型渠道:不同的模型提供商协议,例如 OpenAI、Anthropic、Google 等。大部分自建渠道都遵守 OpenAI 的协议。一个模型可以在配置在不同渠道中,实现负载均衡。
- 自定义请求地址/Key:如果需要绕过
模型渠道,可以设置自定义请求地址和 Token。一般情况下不需要。(不推荐使用,不方便管理)
添加渠道/模型
可以在 FastGPT 的 管理员-模型提供商 页面中进行模型配置。
1. 创建渠道
切换到 模型渠道 标签页。注意,这里只能增加 模型配置 里有的模型,系统仅内置了主流的模型,如果需要增加其他模型,需要先在 模型配置 中增加。
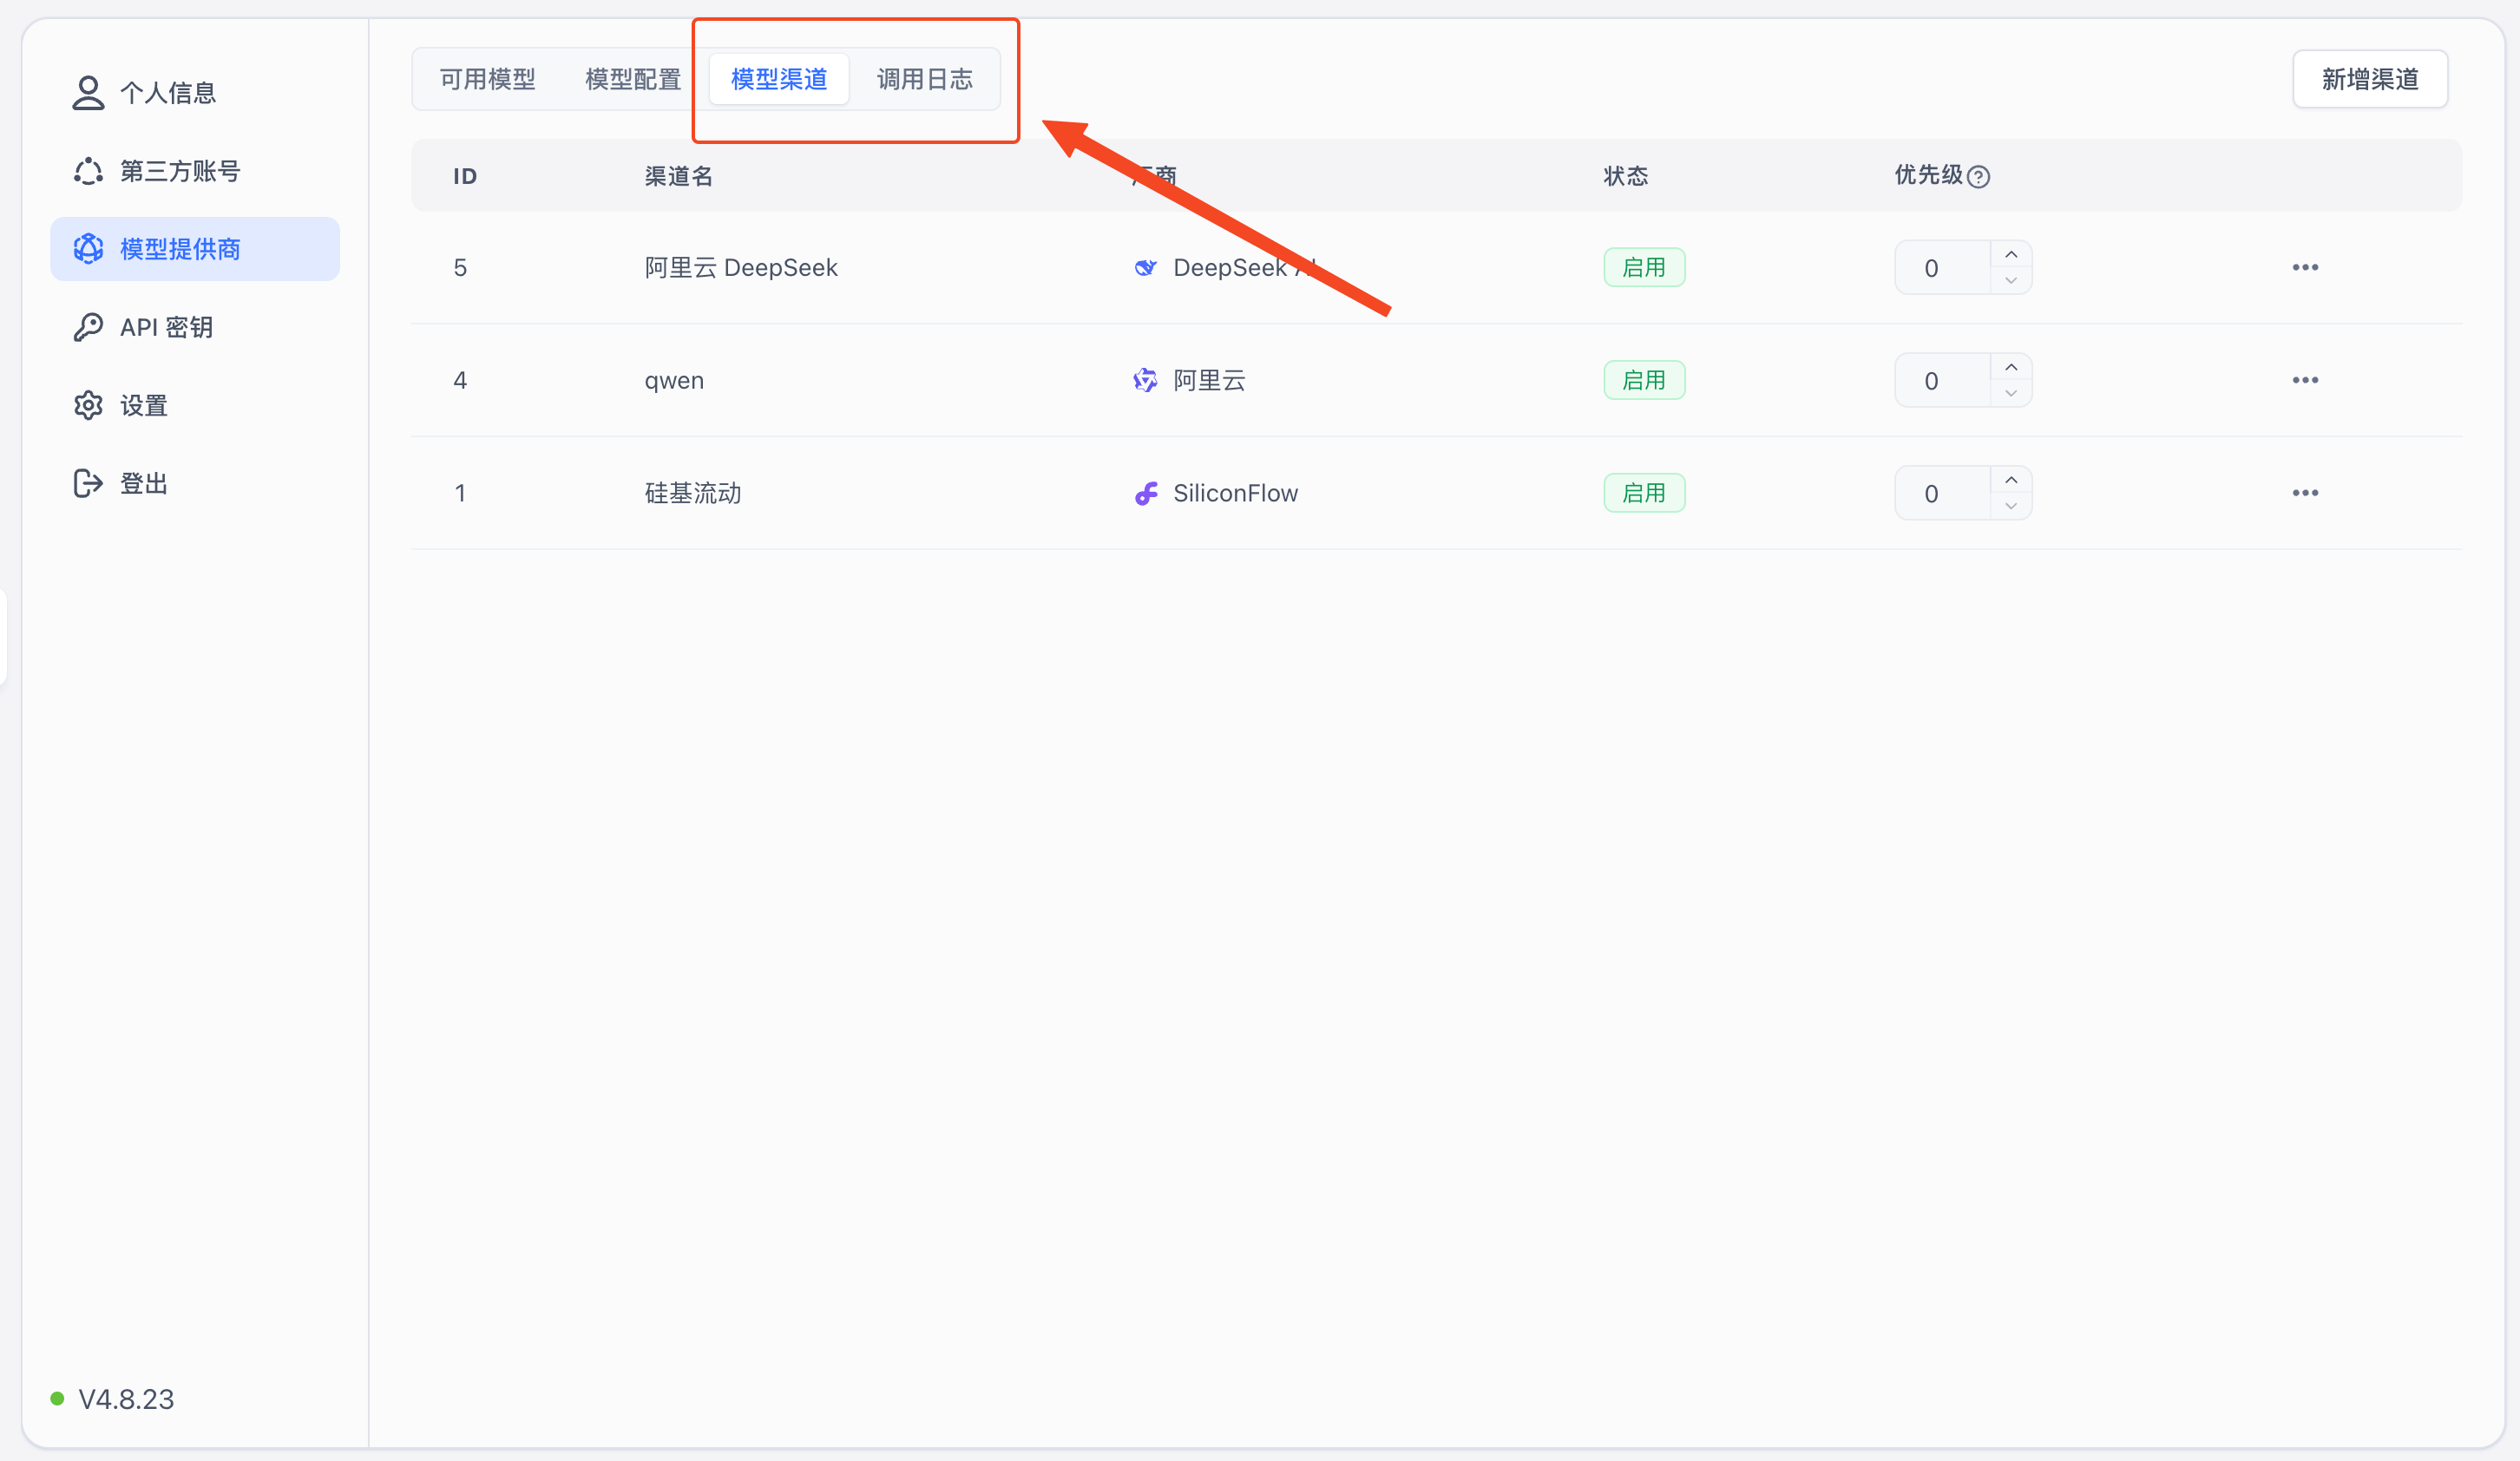
点击右上角的“新增渠道”,即可进入渠道配置页面

以阿里百炼的模型为例,进行如下配置

- 渠道名:展示在外部的渠道名称,仅作标识;
- 协议类型:模型对应的协议类型,一般哪家提供的模型就选对于服务商即可。大多数都提供了 OpenAI 的协议,也可以选择 OpenAI 协议类型。
- 模型:当前渠道具体可以使用的模型,系统内置了主流的一些模型,如果下拉框中没有想要的选项,可以点击“新增模型”,增加自定义模型;
- 模型映射:将 FastGPT 请求的模型,映射到具体提供的模型上。例如:
{
  "gpt-4o-test": "gpt-4o"
}
FatGPT 中的模型为 gpt-4o-test,向 AI Proxy 发起请求时也是 gpt-4o-test。AI proxy 在向上游发送请求时,实际的 model 为 gpt-4o。
- 代理地址:不要填完整的模型请求地址,要填写
BaseUrl,注意是否需要增加/v1 - API 密钥:从模型厂商处获取的 API 凭证。注意部分厂商需要提供多个密钥组合,可以根据提示进行输入。
最后点击“新增”,就能在“模型渠道”下看到刚刚配置的渠道

2. 渠道测试
然后可以对渠道进行测试,确保配置的模型有效

点击“模型测试”,可以看到配置的模型列表,点击“开始测试”

等待模型测试完成后,会输出每个模型的测试结果以及请求时长

3. 启用模型
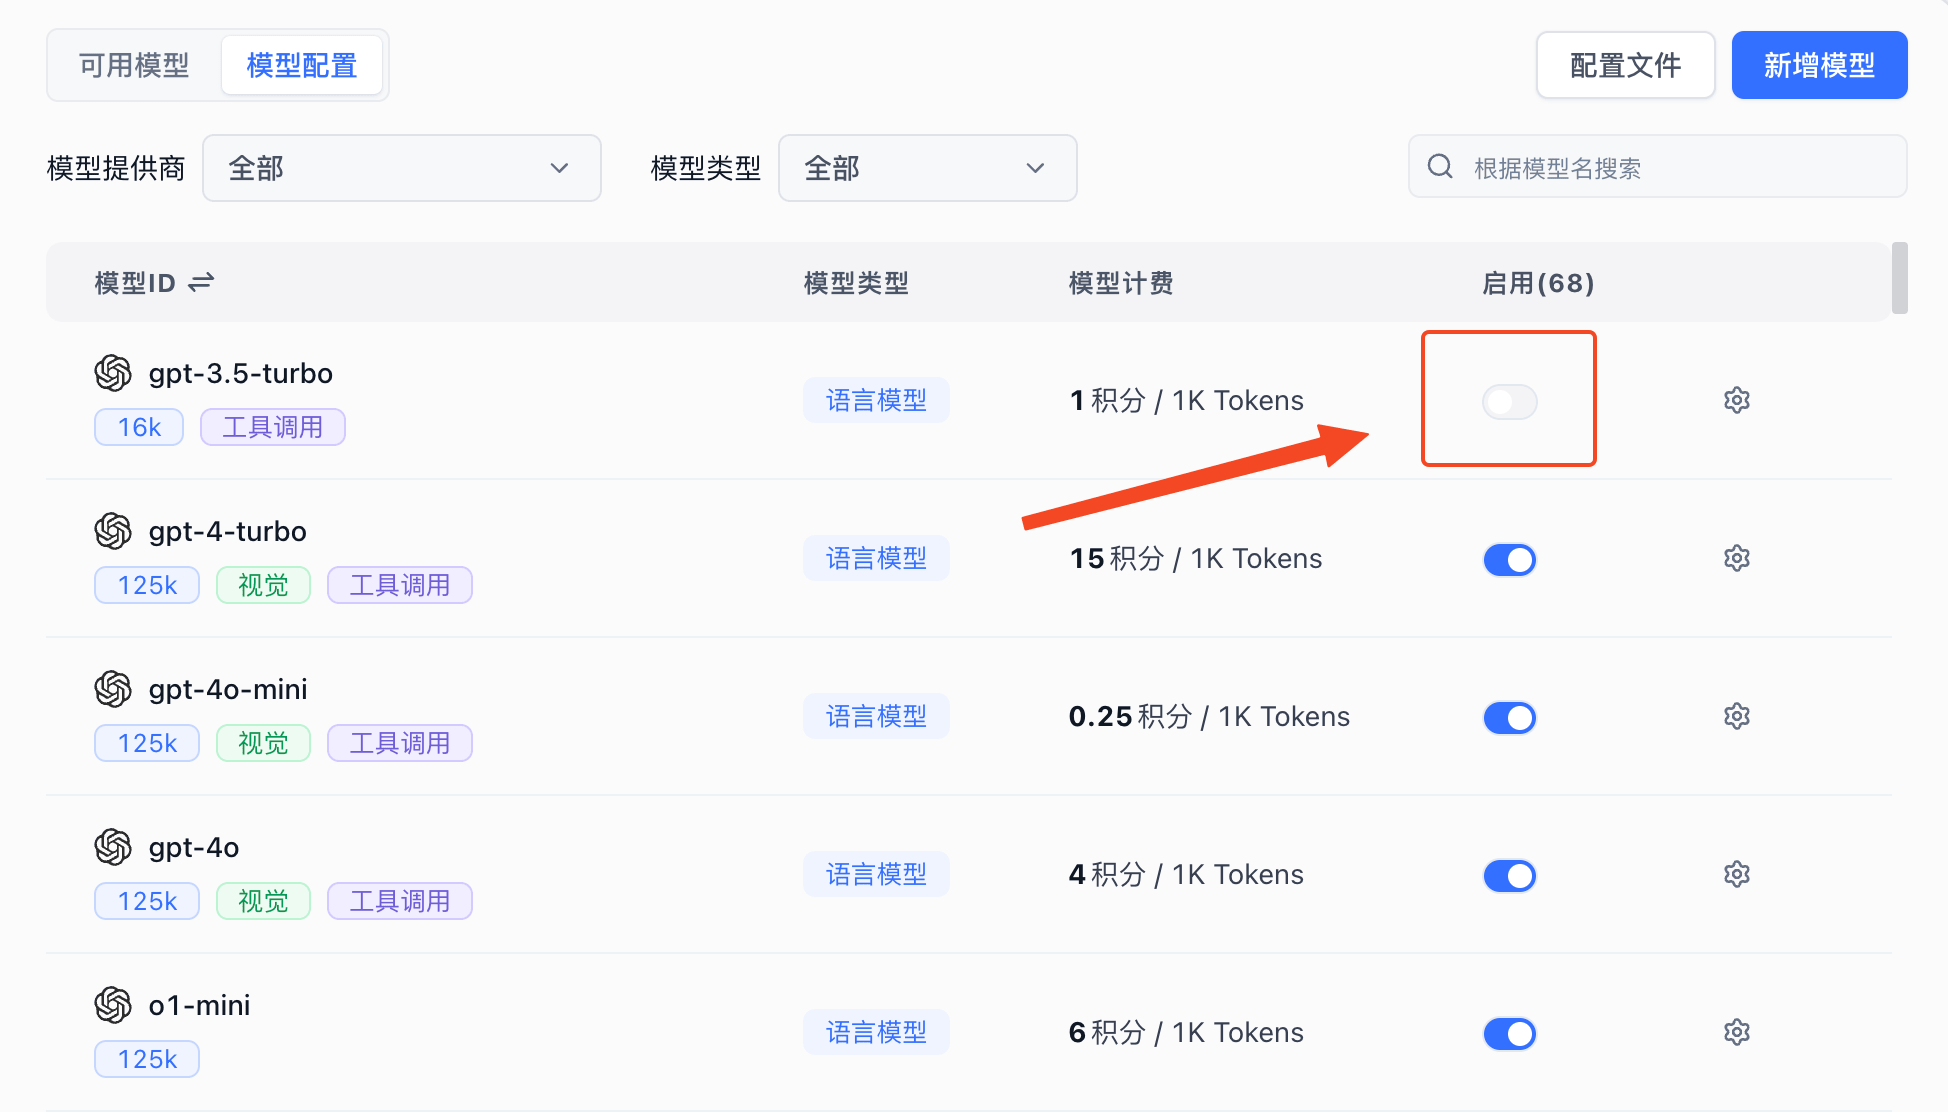
系统内置了目前主流厂商的模型,如果你不熟悉配置,直接点击 启用 即可。模型 ID 是和 模型渠道 中的 模型 一致。
点击启用模型,即可使用。
| 启用模型 | 模型 ID 映射说明 |
|---|---|
 |  |
4. 测试模型
FastGPT 页面上提供了每类模型的简单测试,可以初步检查模型是否正常工作,会实际按模板发送一个请求。

模型配置
修改模型配置
点击模型右侧的齿轮即可进行模型配置,不同类型模型的配置有区别。
 |  |
新增自定义模型
如果系统内置的模型无法满足你的需求,你可以添加自定义模型。如果 模型 ID 与系统内置的模型 ID 重复,则会被认为是修改系统模型,而不是新增模型。
- 通过表单添加模型
 |  |
- 通过配置文件配置
如果你觉得通过页面配置模型比较麻烦,你也可以通过配置文件来配置模型。或者希望快速将一个系统的配置,复制到另一个系统,也可以通过配置文件来实现。
 |  |
模型状态探测
说明
FastGPT 提供了开箱即用的系统模型健康探测与监控功能。开启后,系统会周期性地对所有已启用的模型进行可用性测试,生成 48 小时稳定性图表,并在模型发生故障或恢复时通过 Webhook 发送实时告警。
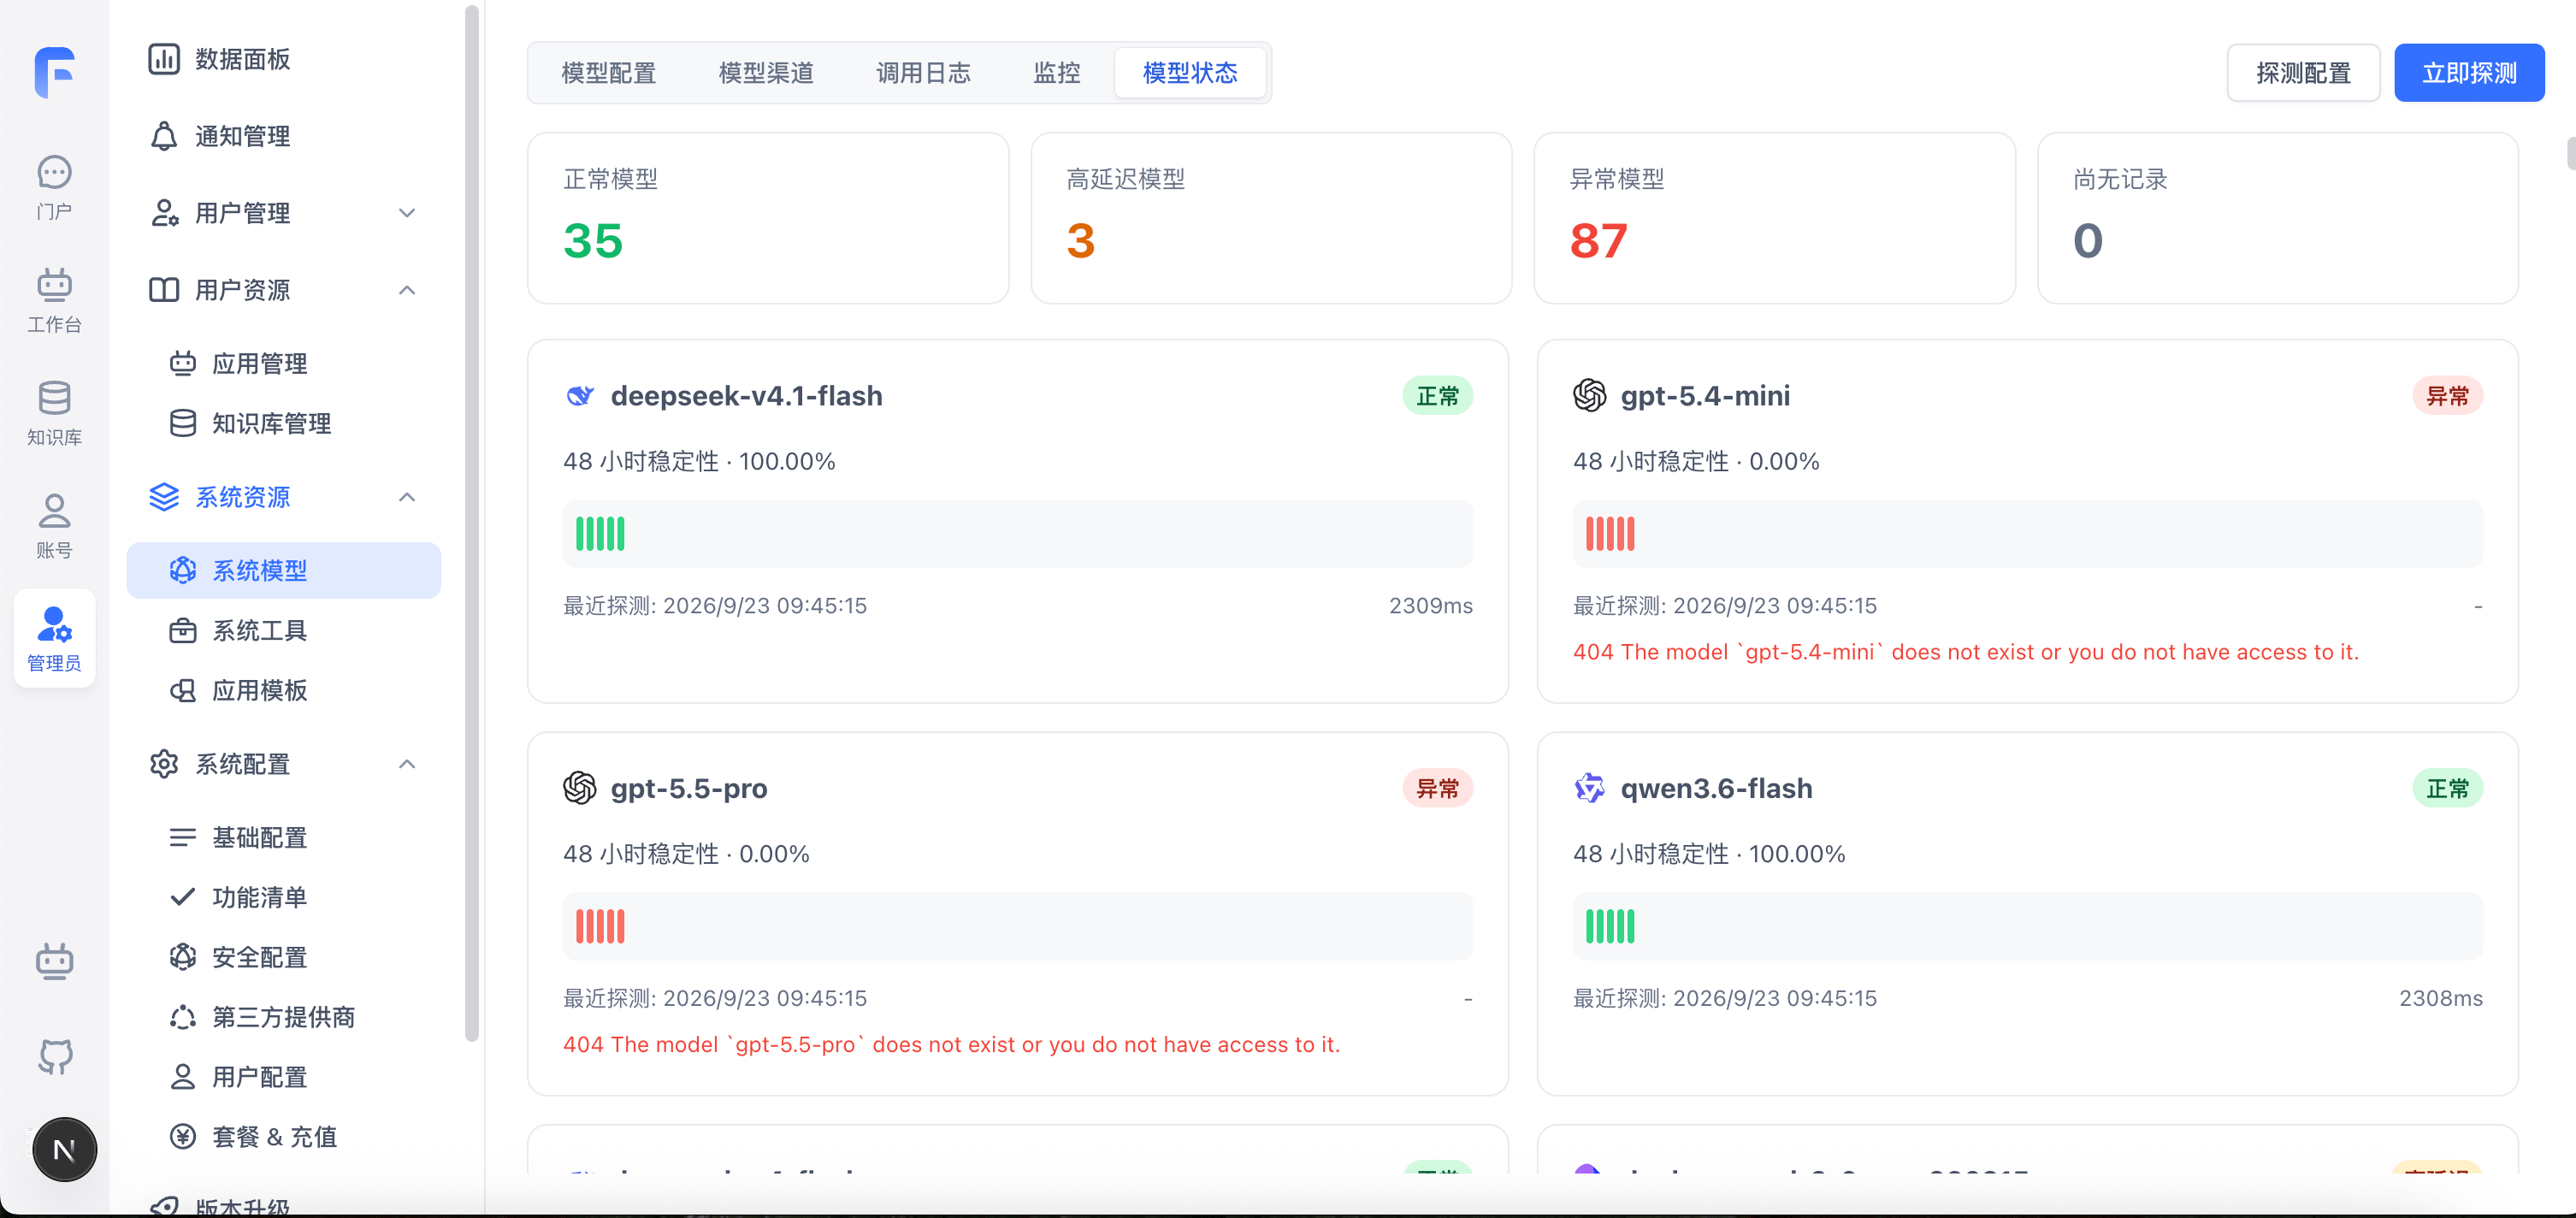
- 探测范围:仅针对系统中当前「已启用」的系统模型。未启用的模型不会参与探测,也不会产生历史记录。
- 重试机制:探测请求首次失败后,系统最多自动重试 3 次(即单轮最多尝试 4 次)。只要有一次调用成功即判定为有效;只有 4 次尝试全部失败时,才最终判定为异常,有效防止因网络瞬间抖动导致的误报。
- 三种健康状态:
- 正常(绿色):模型测试成功,且响应延迟 ≤ 30s。
- 高延迟(黄色):模型测试成功,但响应延迟 > 30s。
- 异常(红色):模型连续 4 次请求均发生错误。
- 前端监控特性:
- 48 小时状态图:以时间线细刻度直观展示历史探测结果,鼠标悬浮至任一刻度条时伴随微动高亮,并通过 Tooltip 展示对应时间点、状态(正常 / 延迟过高 / 错误原因)及延迟。
- 稳定性百分比:统计 48 小时内的成功率(精确保留 2 位小数)。
- 最近错误保留:异常卡片底部直接保留并高亮显示最近一次的详细报错信息,方便直接排查上游问题。
- 无感自动刷新:在自动探测开启的状态下,模型状态页面每 1 分钟自动在后台静默刷新最新数据。
启用方式
管理员可在 FastGPT 管理后台中配置并开启模型探测:
- 进入状态面板:登录管理员账号,点击左侧菜单 系统模型,在顶部标签页中切换至 模型探测。
- 打开探测配置:点击页面右上角的 探测配置 按钮。
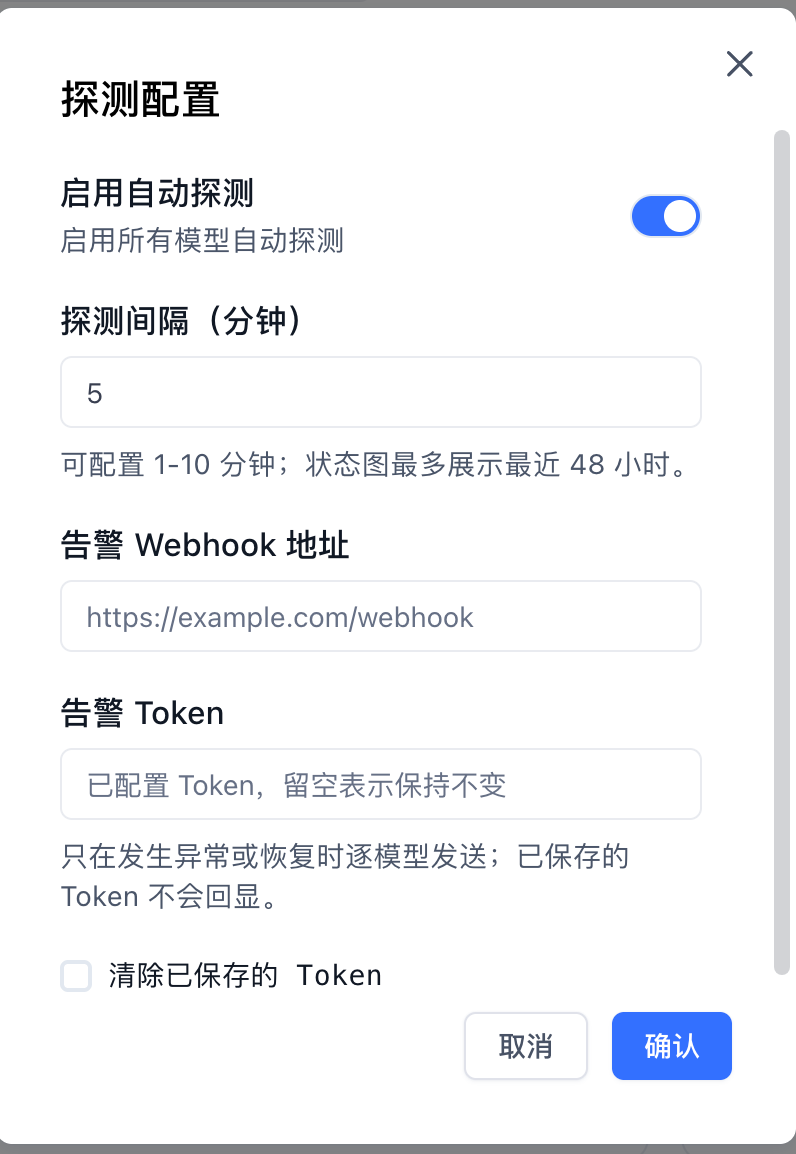
- 设置探测参数:
- 启用自动探测:开启开关(配置项显示为“启用所有模型自动探测”)。开启后,系统内置定时任务按配置间隔自动调度;未开启时,页面将呈现「未启用自动探测」空状态。
- 探测间隔(分钟):填写探测周期,支持配置 5~60 分钟之间的整数。
- 告警 Webhook 地址(可选):接收告警通知的回调 URL(支持 HTTP / HTTPS)。配置后可点击输入框右侧的 测试 按钮验证连通性,系统会依次推送模拟异常和模拟恢复两条测试消息。
- 告警 Token(可选):如果你的 Webhook 接收端需要鉴权,可在此配置 Token。系统在发起推送时会通过请求头携带。
- 保存配置:点击 确认 完成保存。
- 立即探测(可选):在开启探测的状态下,右上角会显示 立即探测 按钮。管理员可随时点击该按钮主动触发一轮全量探测,快速验证所有渠道与模型的实时连通性。
Webhook 标准
当配置了「告警 Webhook 地址」后,系统会在模型状态发生边沿变化时触发推送,每个模型独立发送一条通知,不合并发送。
触发规则
- 故障告警:模型状态由非红色(正常或高延迟)变为红色(异常)时触发,事件类型为
model_status_error。 - 恢复通知:模型状态由红色(异常)恢复为正常或高延迟时触发,事件类型为
model_status_recovered。 - 防风暴机制:如果模型持续处于异常状态,后续探测不会重复推送,避免告警刷屏。
协议规范
- 请求方法:
POST - 超时时间:5 秒
- 请求头(Headers):
Content-Type: application/jsonAuthorization: Bearer <告警Token>(仅在配置了 Token 时携带)
请求体参数说明
| 参数路径 | 类型 | 说明 |
|---|---|---|
event | string | 告警事件类型:model_status_error(模型异常)或 model_status_recovered(模型恢复) |
status | string | 当前探测结果状态:red(异常)、green(正常)、yellow(高延迟) |
model.modelId | string | 模型在系统中的唯一数据库 ID |
model.name | string | 模型别名/展示名称 |
model.model | string | 真实模型标识 |
model.provider | string | 模型厂商标识(如 OpenAI、DeepSeek 等) |
model.type | string | 模型类型(llm、embedding、rerank、tts、stt) |
probe.attempts | number | 本轮探测实际尝试的次数(1~4) |
probe.latencyMs | number | 响应耗时(毫秒,异常状态时通常不存在) |
probe.error | string | 发生异常时的具体错误信息(恢复或正常时通常不存在) |
probe.startedAt | string | 单模型探测任务开始的 ISO 8601 时间戳,包含重试等待 |
probe.requestStartedAt | string | 最后一次模型请求开始的 ISO 8601 时间戳 |
probe.requestEndedAt | string | 最后一次模型请求结束的 ISO 8601 时间戳,也是状态记录时间 |
Webhook 请求示例
1. 模型异常告警报文
{
  "event": "model_status_error",
  "status": "red",
  "model": {
    "modelId": "6732f10283c7ab1289de4567",
    "name": "gpt-5.4-mini",
    "model": "gpt-5.4-mini",
    "provider": "OpenAI",
    "type": "llm"
  },
  "probe": {
    "attempts": 4,
    "error": "404 The model `gpt-5.4-mini` does not exist or you do not have access to it.",
    "startedAt": "2026-09-23T01:44:00.000Z",
    "requestStartedAt": "2026-09-23T01:45:14.000Z",
    "requestEndedAt": "2026-09-23T01:45:15.000Z"
  }
}
2. 模型恢复正常报文
{
  "event": "model_status_recovered",
  "status": "green",
  "model": {
    "modelId": "6732f10283c7ab1289de4567",
    "name": "gpt-5.4-mini",
    "model": "gpt-5.4-mini",
    "provider": "OpenAI",
    "type": "llm"
  },
  "probe": {
    "attempts": 1,
    "latencyMs": 1630,
    "startedAt": "2026-09-23T01:50:13.000Z",
    "requestStartedAt": "2026-09-23T01:50:13.000Z",
    "requestEndedAt": "2026-09-23T01:50:15.000Z"
  }
}
其他
渠道优先级
范围 1~100。数值越大,越容易被优先选中。

启用/禁用渠道
在渠道右侧的控制菜单中,还可以控制渠道的启用或禁用,被禁用的渠道将无法再提供模型服务

模型调用日志
通过渠道调用的模型,可以在 调用日志 页面,会展示发送到模型处的请求记录,包括具体的输入输出 tokens、请求时间、请求耗时、请求地址等等。错误的请求,则会详细的入参和错误信息,方便排查,但仅会保留 1 小时(环境变量里可配置)。

私有部署模型
从 OneAPI 迁移到 AI Proxy
对于旧版使用 OneAPI 的用户,可以通过脚本将 OneAPI 里的渠道配置迁移到 AI Proxy。
可以从任意终端,发起 1 个 HTTP 请求。其中 {{host}} 替换成 AI Proxy 地址,{{admin_key}} 替换成 AI Proxy 中 ADMIN_KEY 的值。
Body 参数 dsn 为 OneAPI 的 mysql 连接串。
curl --location --request POST '{{host}}/api/channels/import/oneapi' \
--header 'Authorization: Bearer {{admin_key}}' \
--header 'Content-Type: application/json' \
--data-raw '{
    "dsn": "mysql://root:s5mfkwst@tcp(dbconn.sealoshzh.site:33123)/mydb"
}'
执行成功的情况下会返回 "success": true
脚本目前不是完全准,仅是简单的做数据映射,主要是迁移 代理地址、模型 和 API 密钥,建议迁移后再进行手动检查。
文件更新时间