接入 OXR PDF 文档解析
使用 Docker 部署 OXR,为 FastGPT 提供本地 PDF 识别能力,支持离线运行和单机多卡
SoMark OXR-1.0 可以识别 PDF 中的文字、表格、公式和图片,并转换为 Markdown。本文使用已适配 FastGPT 的 Docker 镜像,内置模型权重,拉取镜像后无需联网下载模型。镜像公开,可免登录拉取。
1. 环境要求
- Linux x86_64,已安装 Docker 和 NVIDIA Container Toolkit。
- NVIDIA Ampere 或更新架构的 GPU,计算能力至少为 8.0;建议每张卡至少 16 GB 显存,推荐 24 GB 及以上,并预留足够空闲显存。
- 支持 CUDA 13.0 的 NVIDIA 驱动,Linux 版本至少为 580.65.06,详见 CUDA 13.0 驱动要求。
- 单卡建议 8 核 CPU、32 GB 系统内存,Docker 数据盘至少有 50 GB 可用空间。
2. 启动服务
在 GPU 服务器执行:
docker run -d --name oxr \
  --restart unless-stopped \
  --gpus device=0 \
  --shm-size=8g --cpus=8 --memory=32g \
  -p 18080:8000 \
  -v oxr-cache:/cache \
  --log-opt max-size=20m --log-opt max-file=3 \
  crpi-h3snc261q1dosroc.cn-hangzhou.personal.cr.aliyuncs.com/fastgpt_ck/oxr:1.0.2-cu130
此命令只使用第 0 张显卡,对外端口为 18080。oxr-cache 保存启动时生成的编译缓存,日志按大小自动轮转。
--shm-size 设置共享内存上限,--cpus 和 --memory 限制容器可使用的 CPU 和系统内存,不是 GPU 显存限制,也不会立即占满这些资源。
首次启动需等待模型加载和预热。可以使用 docker logs -f oxr 查看进度,以下检查返回 "status":"healthy" 后即可接入:
curl --fail http://127.0.0.1:18080/health3. 接入 FastGPT
在现有 config.json 的 systemEnv 中添加或修改 customPdfParse,将 GPU_SERVER_IP 替换为 FastGPT 服务端可以访问的 GPU 服务器地址:
{
  "systemEnv": {
    "customPdfParse": {
      "url": "http://GPU_SERVER_IP:18080/v2/parse/file",
      "key": "",
      "price": 0
    }
  }
}默认无需密钥,key 留空。通过配置文件修改后需重启 FastGPT。
商业版可进入「管理员 → 系统配置 → 基础配置 → PDF 解析配置」,在「自定义 PDF 解析地址(第一优先级)」中填写服务 URL,默认将「自定义 PDF 解析密钥」留空,然后点击「保存」。

截图中的 IP 为示例,请替换为自己的 GPU 服务器地址,并保留 /v2/parse/file 路径。
FastGPT 运行在其他容器中时,不要把地址填为 127.0.0.1,应使用 GPU 服务器 IP 或同一 Docker 网络内可访问的服务地址。
在知识库导入 PDF 时启用「PDF 增强解析」,即可使用 OXR。应用上传文件时,也可以在文件上传配置中启用该选项。
API 自测
将 sample.pdf 替换为本地 PDF 文件:
curl --fail-with-body \
  -F 'file=@./sample.pdf' \
  http://GPU_SERVER_IP:18080/v2/parse/file
返回格式:
{
  "pages": 2,
  "markdown": "# Parsed content\n\nText, tables, formulas and images."
}
pages 为页数,markdown 为解析结果。提取的图片以 base64 形式嵌入 Markdown,由 FastGPT 转存。
4. 并发与多卡配置(可选)
服务在启动时根据每张卡的空闲显存选择识别并发,默认每张卡同时处理 1 份文档。
| 参数 | 默认值 | 说明 |
|---|---|---|
OXR_DOCUMENT_CONCURRENCY | 1 | 每张卡同时处理的文档数,范围 1–4 |
OXR_RECOGNITION_CONCURRENCY | auto | 每张卡同时识别的文档区域数,可手动设为 1–32 |
FASTGPT_PARSE_TIMEOUT | 540 | 单次请求超时,单位为秒,包含排队时间 |
OXR_MAX_UPLOAD_MB | 64 | 上传请求大小上限,单位为 MiB |
FASTGPT_API_KEY | 不设置 | 可选;设置后启用 Bearer 鉴权 |
OXR_LOG_LEVEL | INFO | 文件处理日志级别;DEBUG 显示内部访问和模型统计 |
OXR_PROGRESS_INTERVAL_SECONDS | 10 | 长文件进度日志的最小间隔,单位为秒,范围 1–300 |
例如每张卡同时处理 2 份文档、8 路区域识别,在 docker run 的镜像地址前加入:
-e OXR_DOCUMENT_CONCURRENCY=2 \
-e OXR_RECOGNITION_CONCURRENCY=8
并发越高不一定越快。手动配置超出估算显存预算时,服务会报错;应释放显存或降低并发。
使用多张 GPU
使用第 0、1 张卡时,将启动命令中的 --gpus device=0 替换为:
--gpus '"device=0,1"'使用全部可见 GPU 时可改为 --gpus all。每张卡独立加载一份完整模型,共用同一个 API 地址,由服务分配文档请求;显存不会合并。
多卡时需同步增加 CPU、系统内存和共享内存。双卡建议将资源参数调整为:
--shm-size=16g --cpus=16 --memory=64g修改环境变量或 GPU 参数后需要重新创建容器,单纯执行 docker restart 不会更新这些参数。
启用密钥
如需鉴权,在启动命令的镜像地址前加入 -e FASTGPT_API_KEY=your-api-key,并在 FastGPT 的 customPdfParse.key 中填写相同密钥。直接调用 API 时需增加 Authorization: Bearer your-api-key 请求头。
5. 离线部署(可选)
在有网络的机器上拉取并导出镜像:
docker pull crpi-h3snc261q1dosroc.cn-hangzhou.personal.cr.aliyuncs.com/fastgpt_ck/oxr:1.0.2-cu130
docker save crpi-h3snc261q1dosroc.cn-hangzhou.personal.cr.aliyuncs.com/fastgpt_ck/oxr:1.0.2-cu130 | gzip -1 > oxr.tar.gz
将 oxr.tar.gz 复制到离线服务器,导入镜像后按第 2 步启动:
gunzip -c oxr.tar.gz | docker load6. 查看日志与排查问题
查看最近 10 分钟并持续跟随日志:
docker logs --since 10m --tail 100 -f oxr默认输出简洁英文日志,可看到排队、GPU 分配、解码、版面分析、识别和完成结果。同一请求使用相同的 request_id,长文件默认每 10 秒最多输出一次进度汇总。
document.completed:OXR 已完成文件解析。request.completed:OXR 已完成 API 响应;FastGPT 后续还需分块和向量化。document.failed:解析失败,可根据stage、reason和耗时定位。
| 问题 | 处理方法 |
|---|---|
| 启动失败或显存不足 | 用 nvidia-smi 检查空闲显存,查看 docker logs --tail 100 oxr,释放显存或降低并发 |
| FastGPT 连接失败 | 确认 FastGPT 服务端可以访问 18080 端口,URL 包含 /v2/parse/file,密钥与服务配置一致 |
| 大文件解析超时 | 先拆分 PDF;需要延长超时时,同时调整 FASTGPT_PARSE_TIMEOUT、FastGPT 的 PARSE_FILE_TIMEOUT_SECONDS 和反向代理超时 |
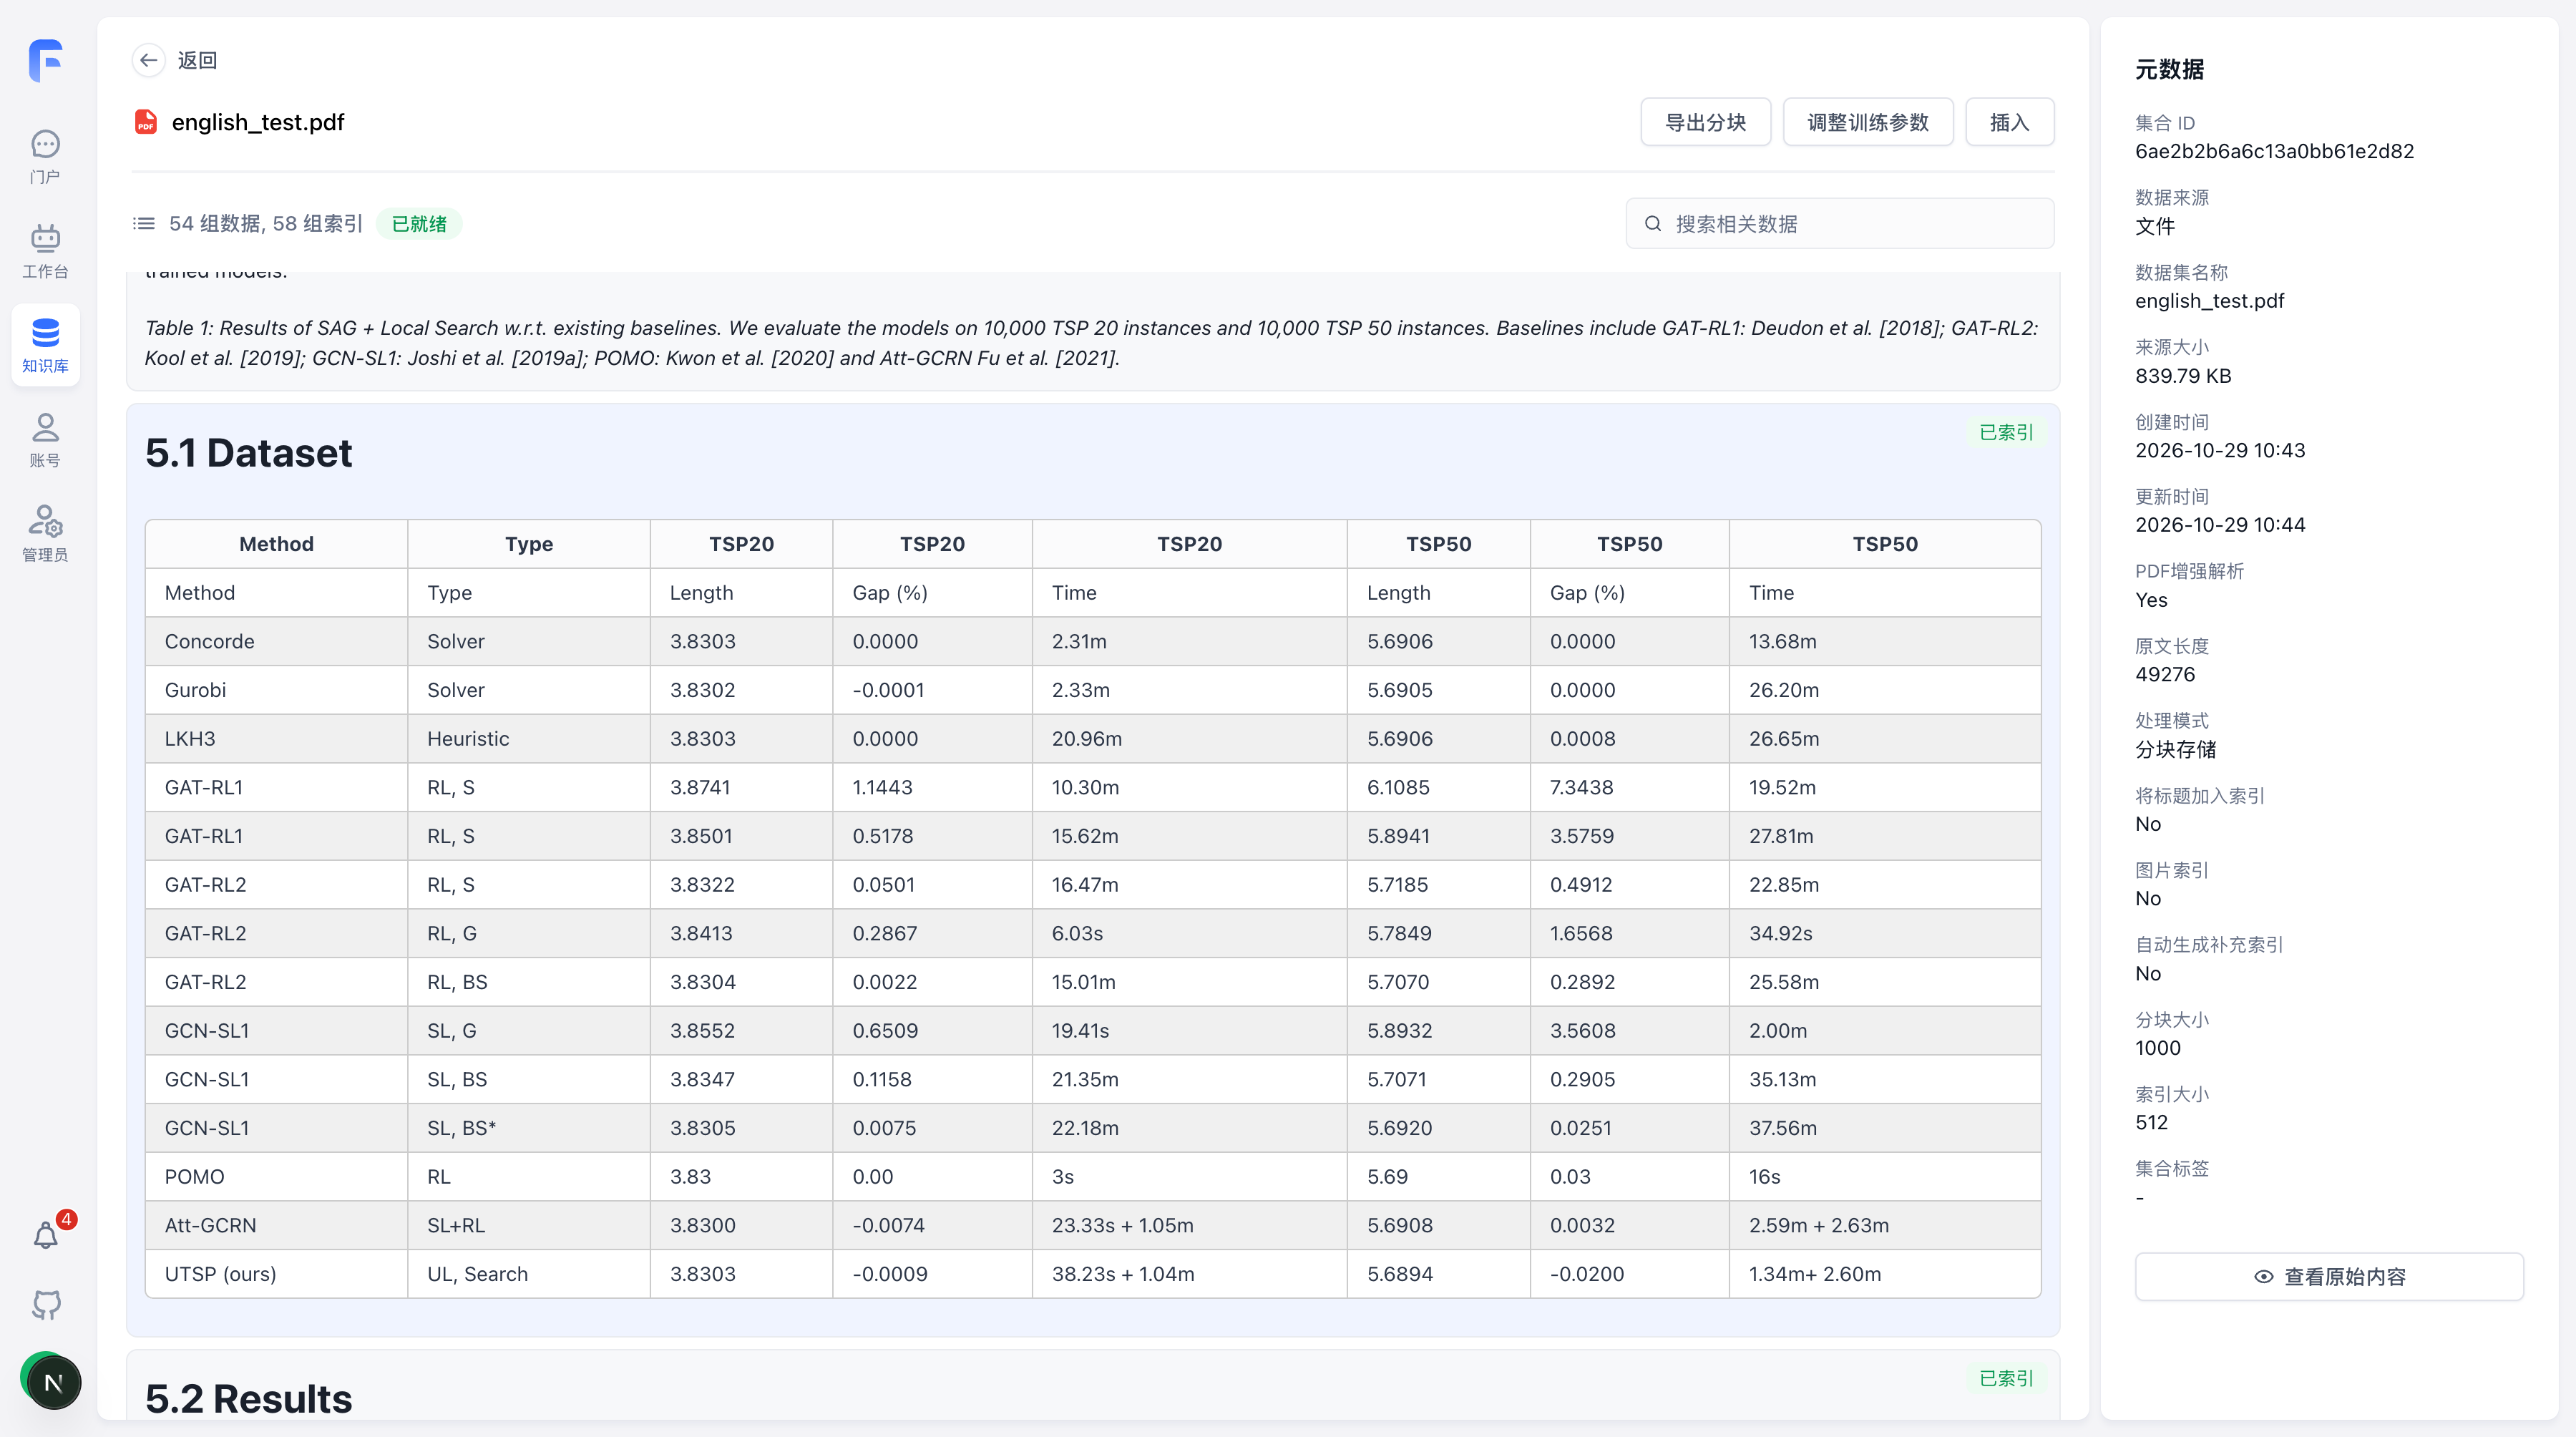
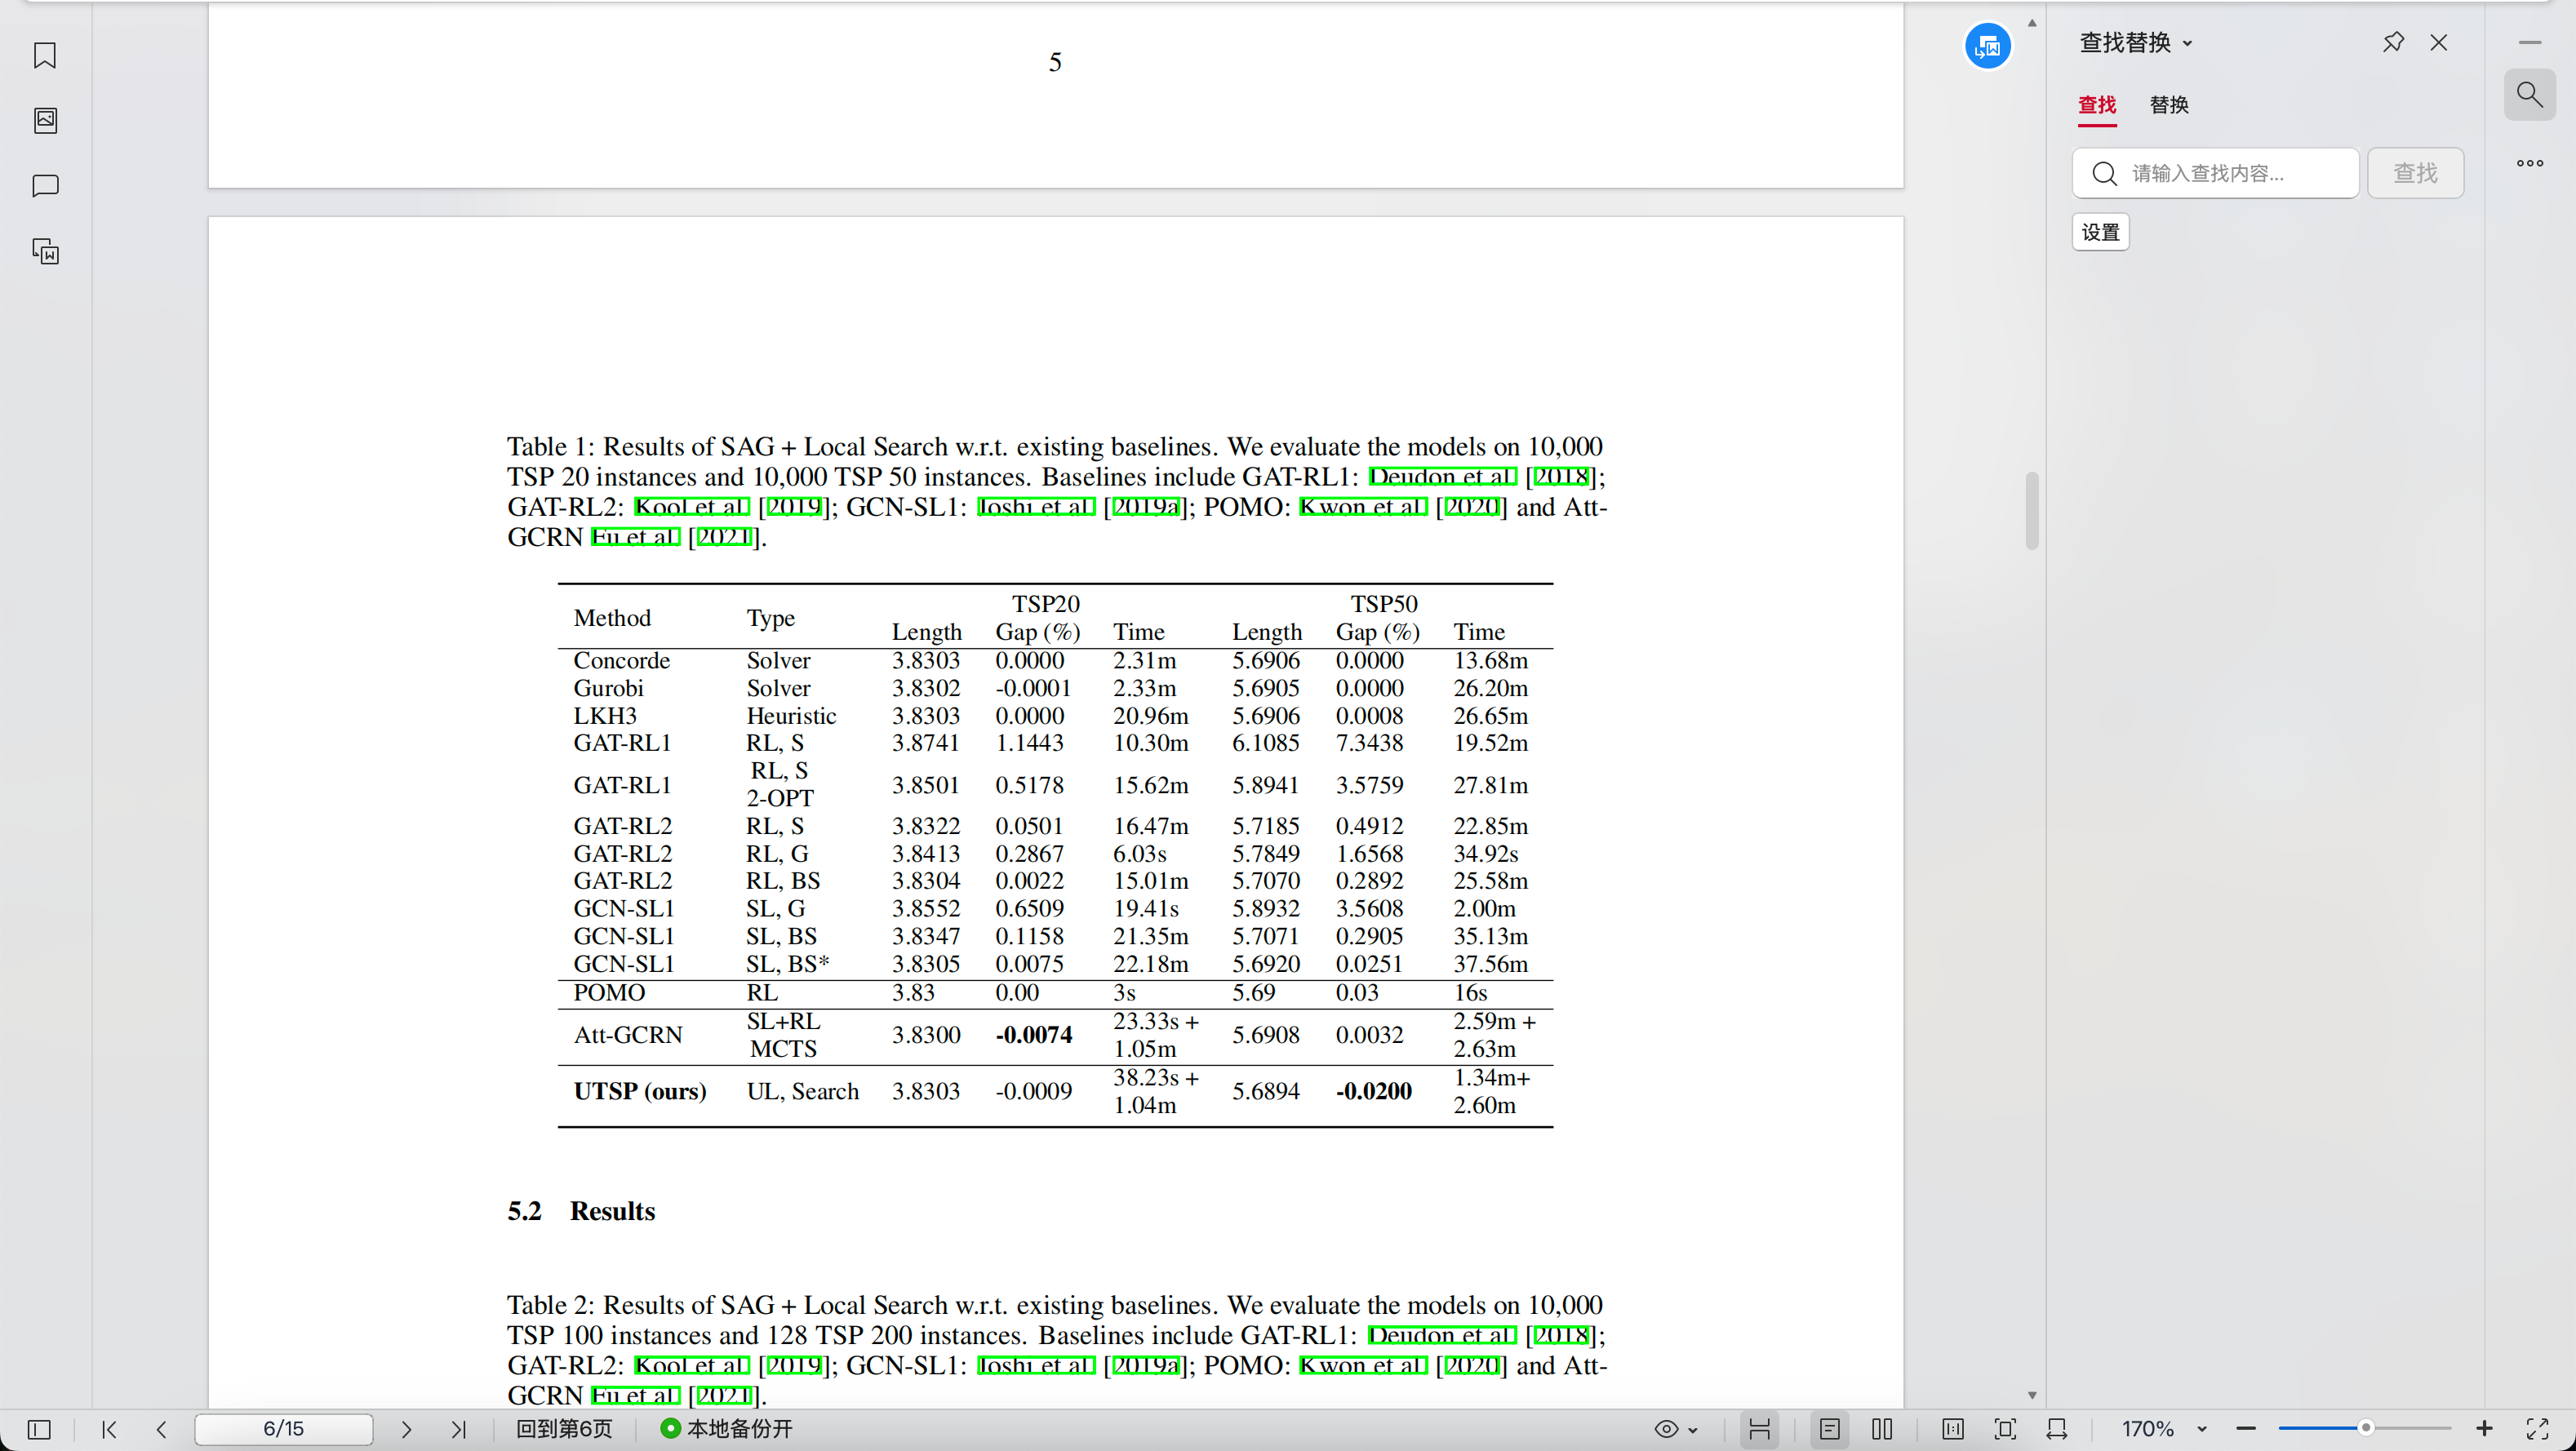
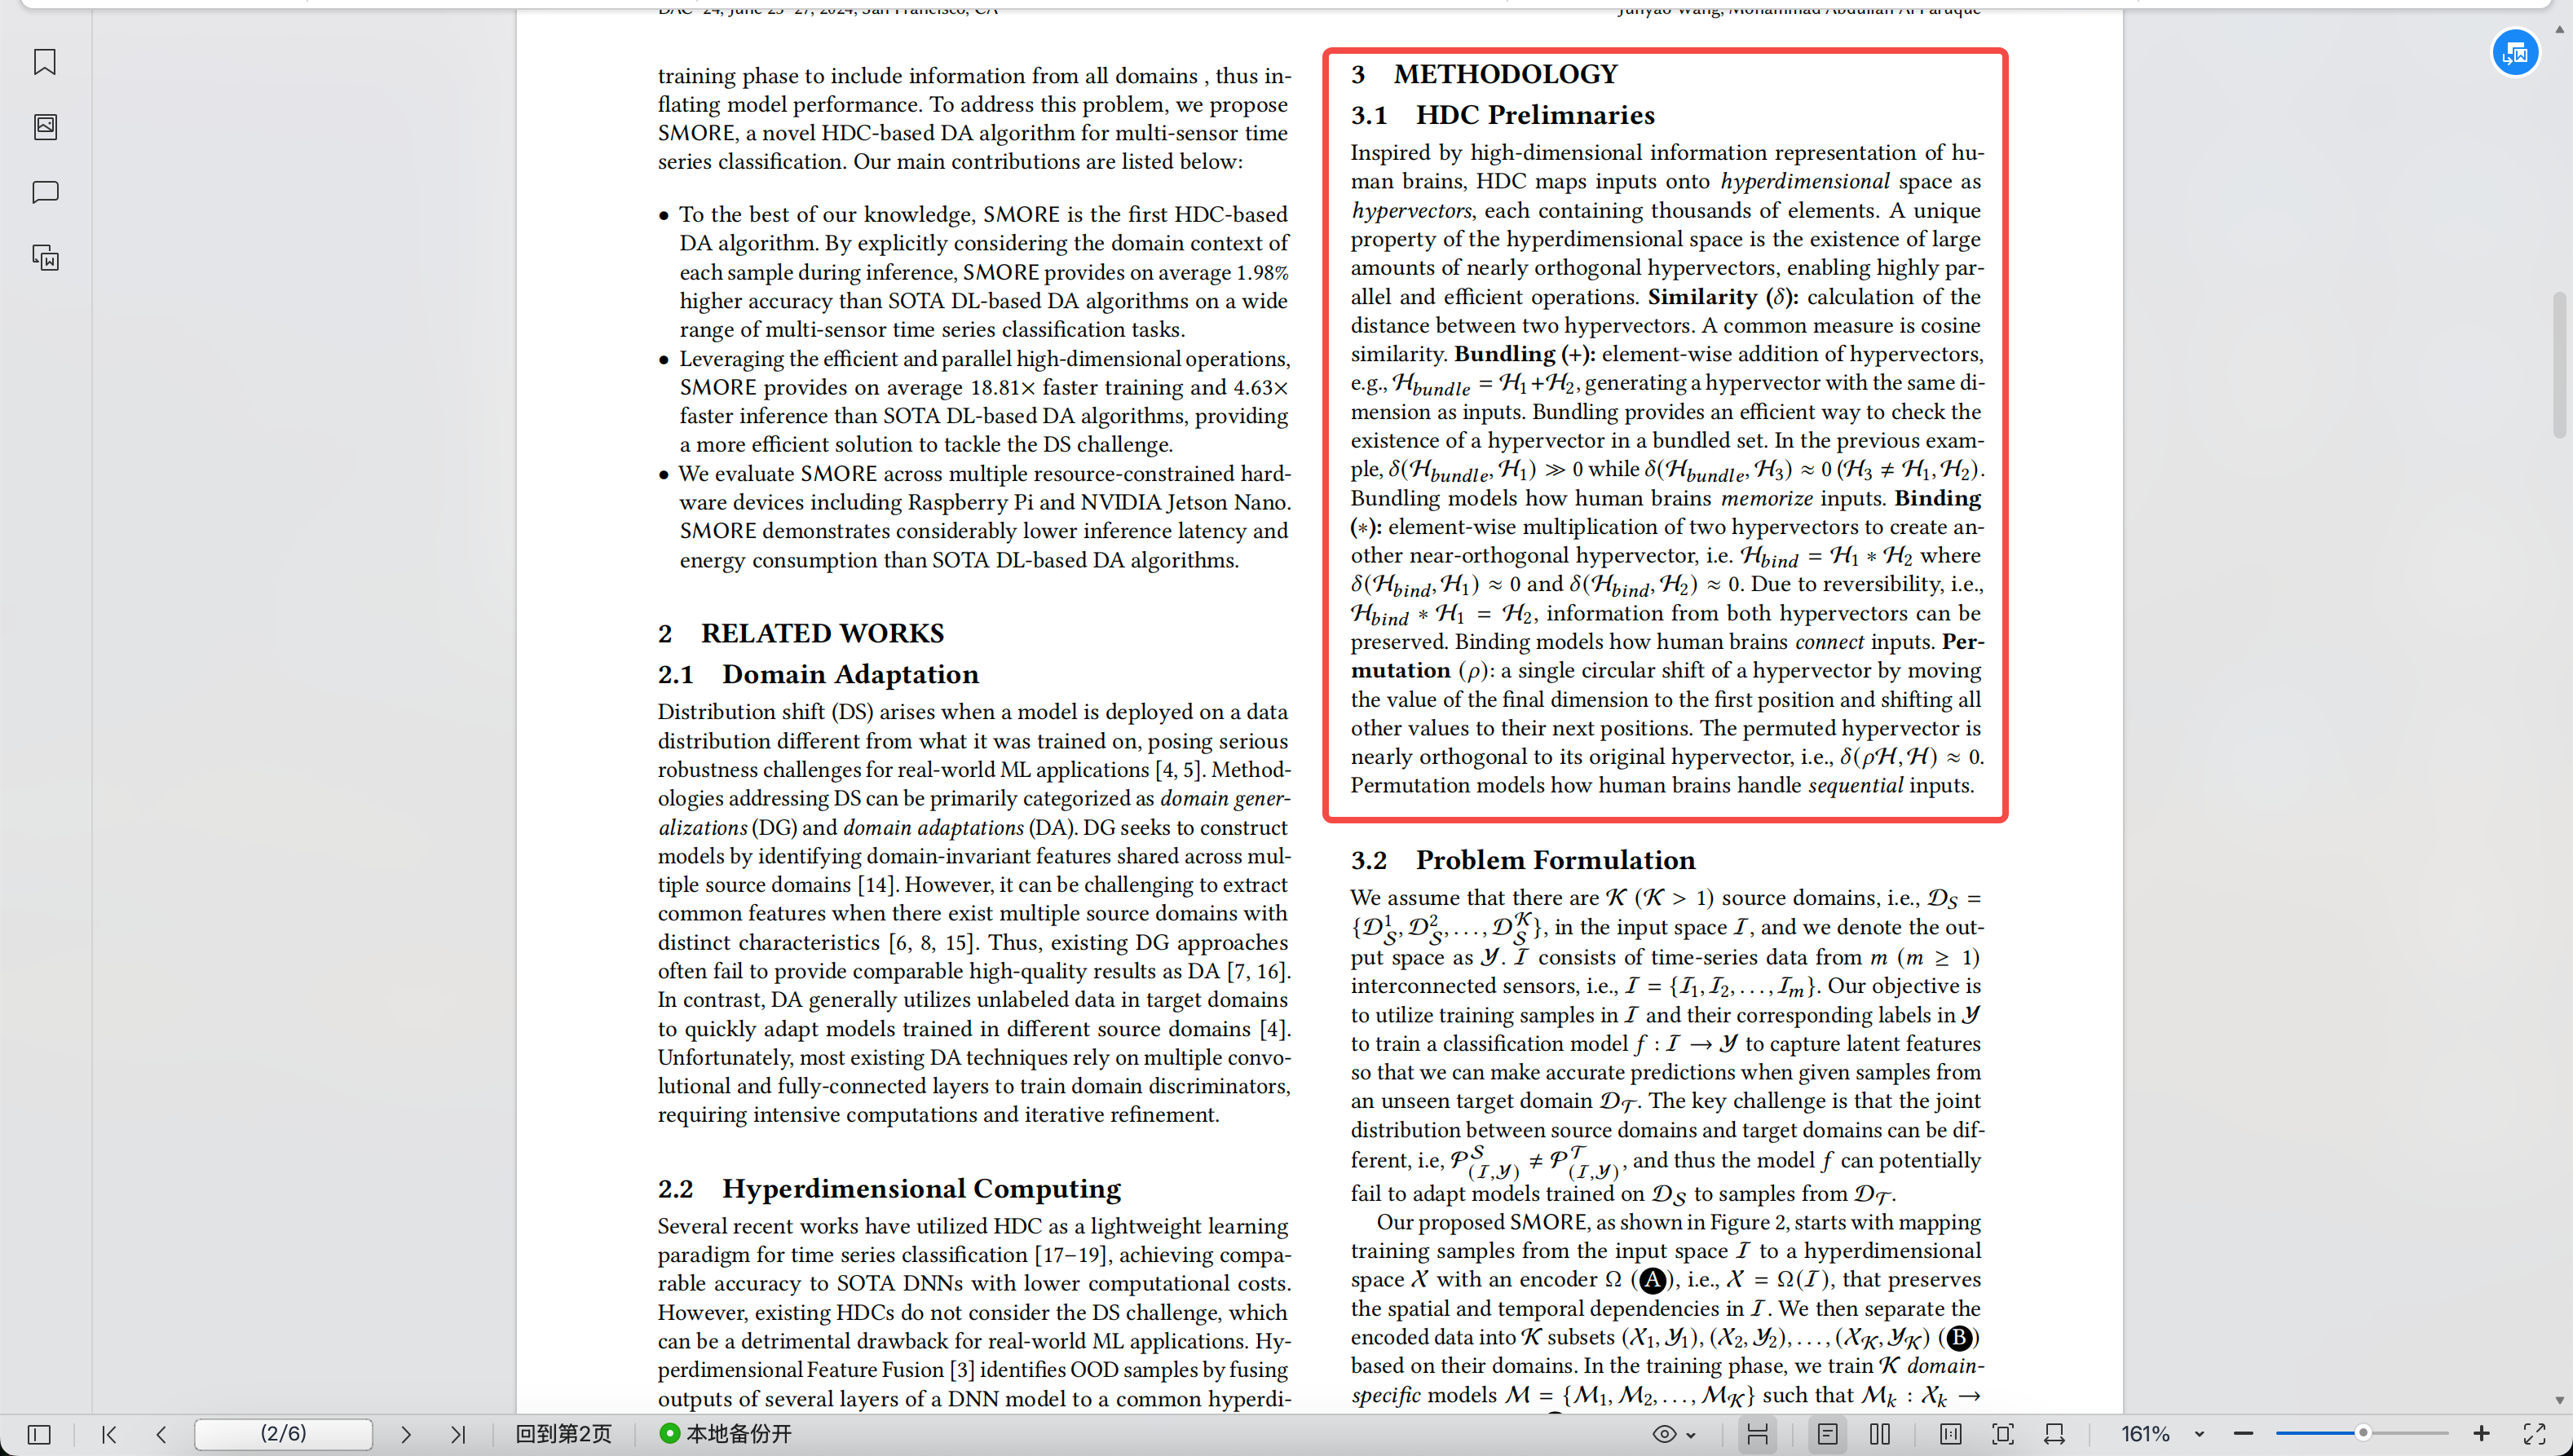
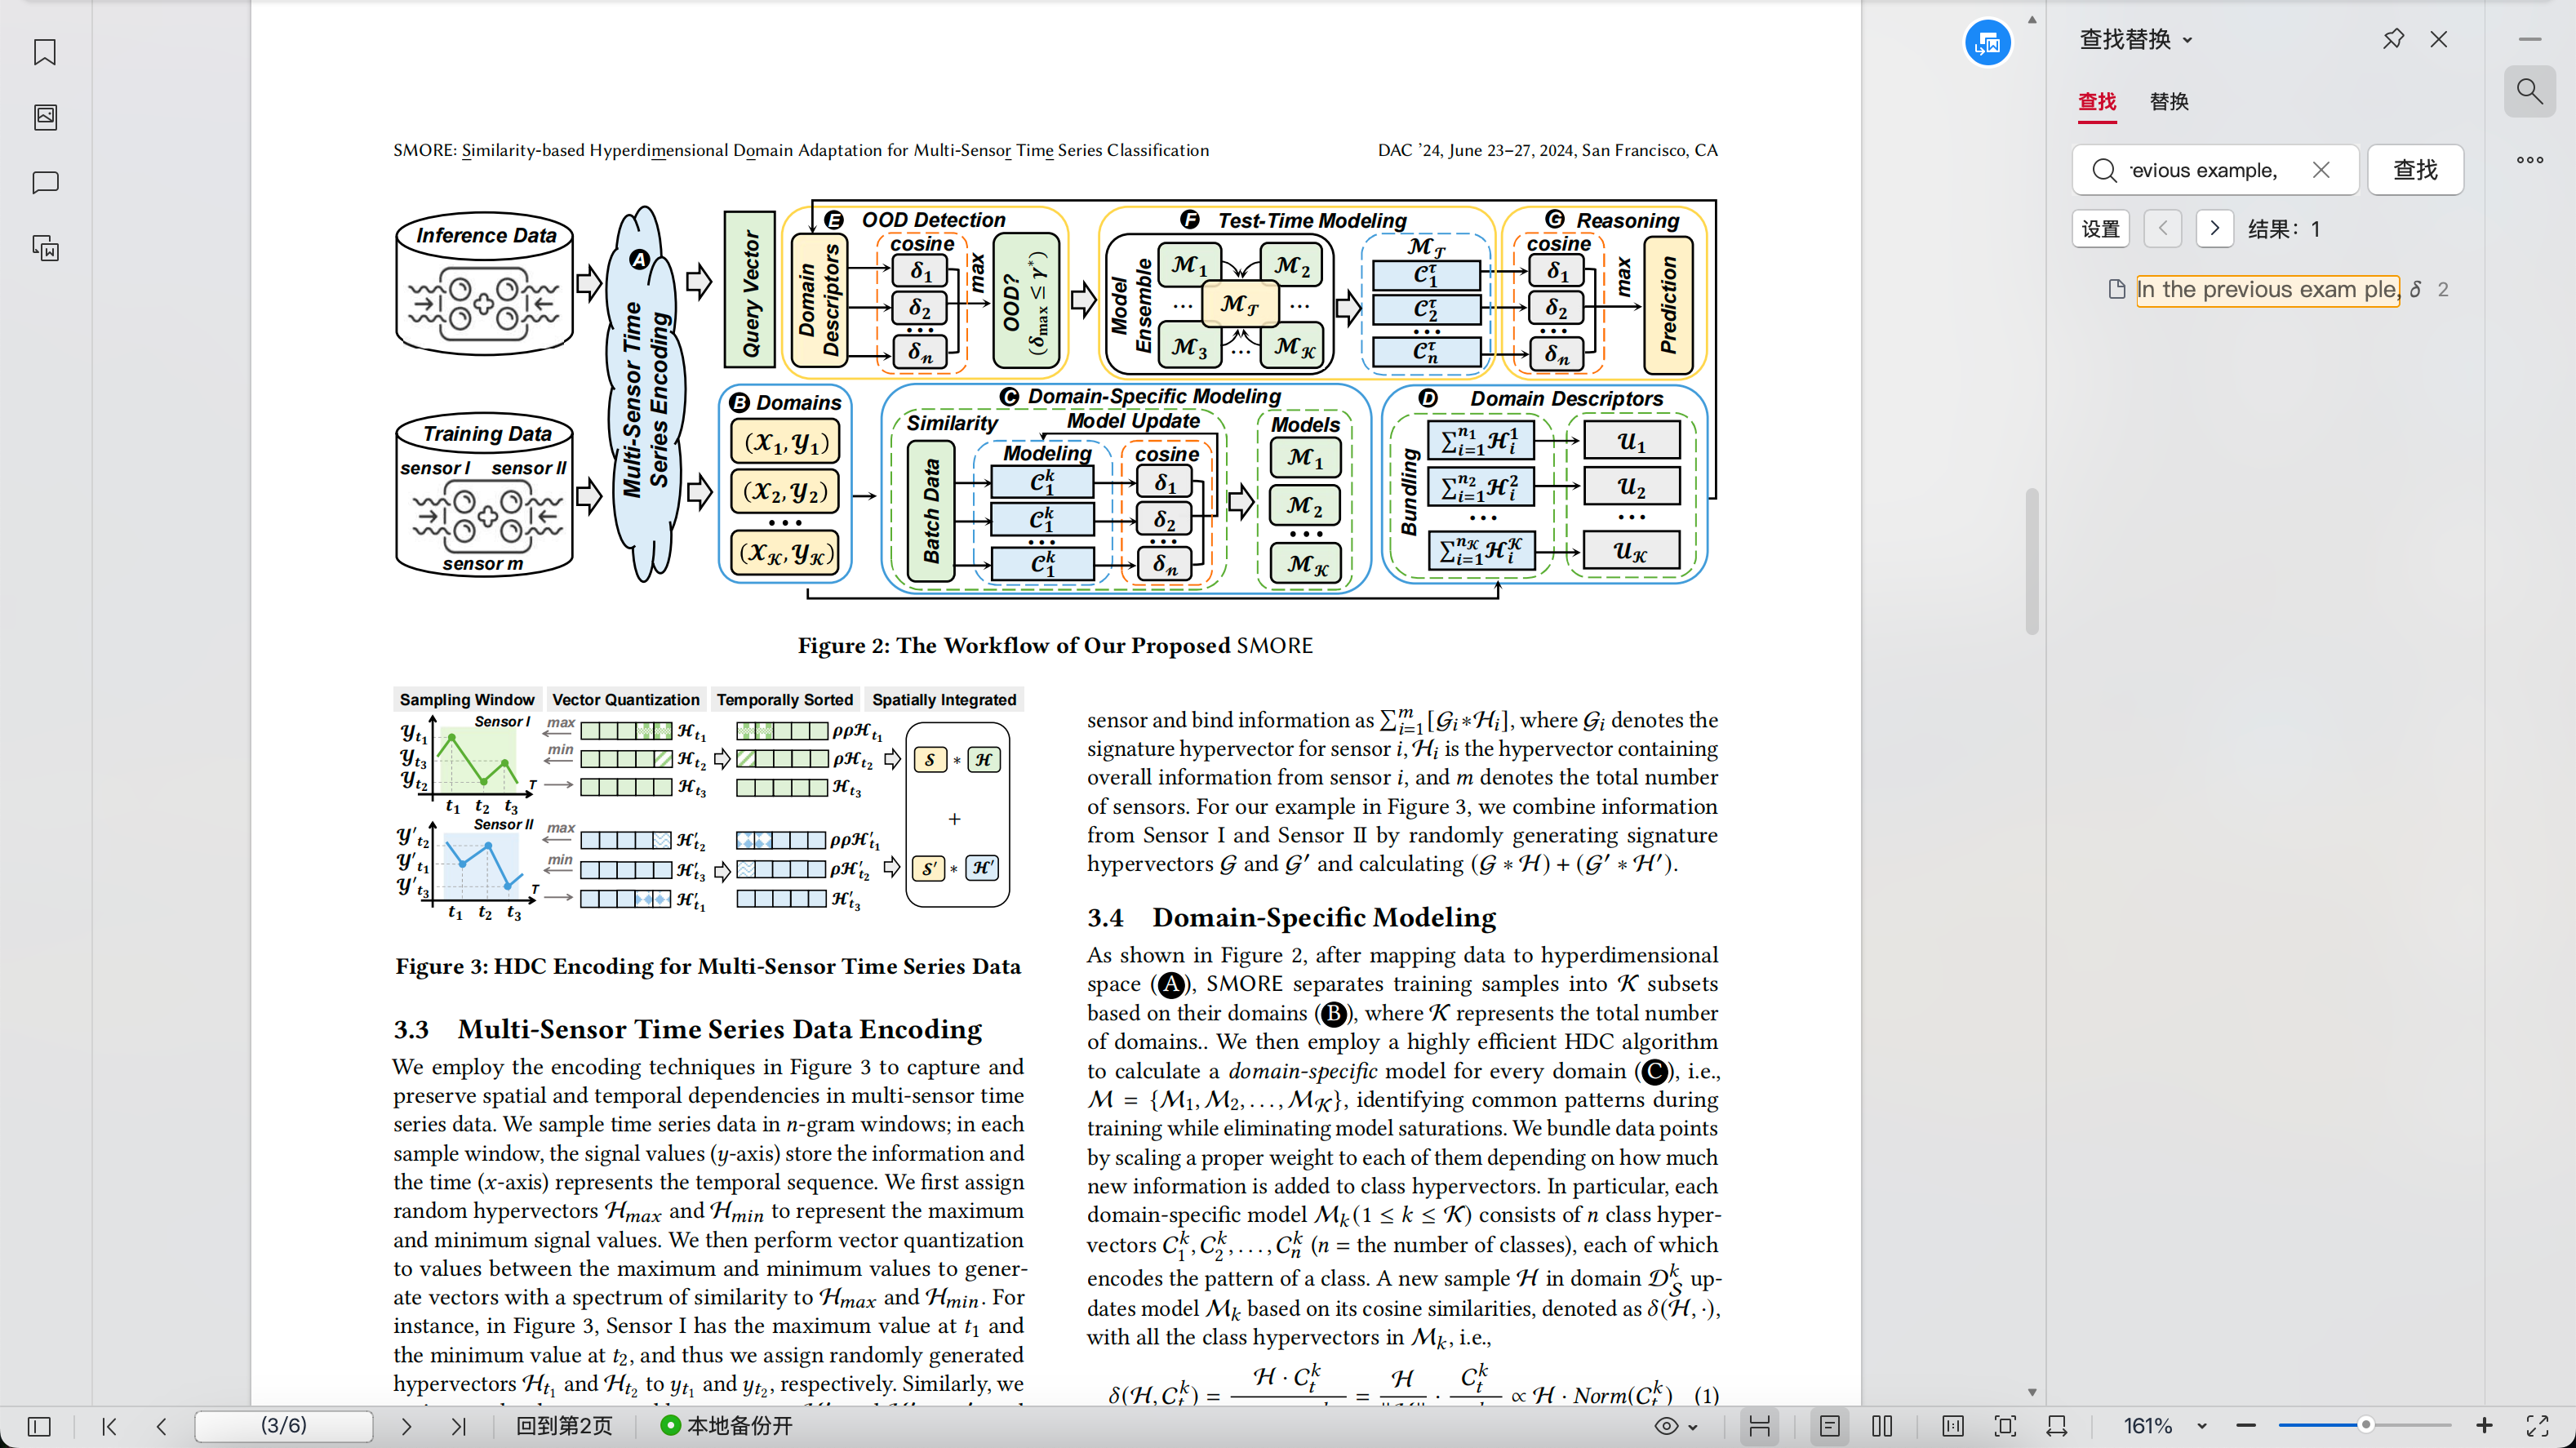
7. 效果展示
以下为启用 OXR 后在 FastGPT 知识库中的实际解析结果。每组可切换查看「OXR 识别结果」与「原始 PDF」,点击图片可放大。
文字与公式
对照双栏论文中的章节标题、正文和行内公式,查看解析后在 FastGPT 中的展示效果。

插图与图注
对照论文中的流程图、示意图和图注,查看图片提取后与正文一起展示的效果。

表格
对照原 PDF 中的实验数据表,查看解析后表头、数据行和数值在 FastGPT 中的展示效果。